Für mein Machine Learning Zertifikat bei der velpTEC GmbH habe ich ein Modell zur Vorraussage der Kreditwürdigkeit erstellt. Die besondere Leistung war dabei das Identifizieren und Ausgleichen eines starken Gender-Biases, der nicht aus der Datenhistorie resultierte. Für das Projekt erhielt ich die Bestnote von 100 %, für die gesamte Weiterbildung als Computer Vision Engineer 99 % der Bestnote.
Projektdokumentation
Die Aufgabenstellung dieses Projektes ist das Training von Modellen zur Vorraussage der Kreditwürdigkeit (Credit Score). Es steht ein Datensatz zur Verfügung, der mit 2 verschiedenen Machine Learning Modellen (K-nearest Neighbor, Decision Tree) trainiert werden soll und zusätzlich mit einem einfachen Neuronalen Netz mit einem versteckten Layer.
Vorgegebenes Ziel ist es bei jedem Klassifikationsalgorythmus eine möglichst hohe Accuracy zu erreichen. Diese Dokumentation soll dabei die Vorgehensweise festhalten sowie, wie Änderungen bei dem Modell sich jeweils auf die Accuracy ausgewirkt haben.
Vorab die Resultate in kurzer Form:
| Modell | Ausgangspunkt | Finaler Stand | Entscheidende Metrik |
|---|---|---|---|
| K-Nearest Neighbor | Train Accuracy 95,4 %, Test Accuracy 90,9 % | CV Macro-F1 96,5 %, Test Accuracy 90,5 %, Train Accuracy 96,3 %, | Macro-F1 + 5-Fold-CV |
| Decision Tree | Train Accuracy 95,1 %, Test Accuracy 90,5 %, Tiefe 5 | CV Macro-F1 96,5 %, Test Accuracy 90,5 %, optimierte Tiefe 2 Train Accuracy 97,5 %, | Macro-F1 + Fold-Stabilität |
| Neuronales Netz | erster NN Testlauf bereits bei. 98,8 % Train / 100 % Test | 98,8 % Train Accuracy, 100 % Test Accuracy, Train Macro-F1 ca. 99 %, Test Macro-F1 100 % | Accuracy, Macro-F1 und Loss-Verlauf |
Anmerkung: Die Modelle starten teils bereits mit sehr hohen Werten, die Accuracy hat sich aber bei genauerer Betrachtung als trügerisch herausgestellt wegen sehr ungleicher Verteilung der Klassen. Die späteren Modelle sind auch hier optimiert.
Das Modell ist so aufzubauen, dass es später die gelieferten Daten in Kategorien einzuteilt, die den Credit Score darstellen. Neben Einkommen, Alter oder Wohnbesitz ist in dem Datensatz auch das Geschlecht angegeben. Das hat das Potential zu einem Gender Bias zu führen, der Personengruppen diskriminiert. Darauf will ich zusätzlich differenziert eingehen.
An dieser Stelle sei vorweggenommen, dass die Betrachtung eines Gender Bias und die entsprechenden Maßnahmen (zusätzliche Stratifizierung) im Verlauf des Projektes zu einer Verbesserung der Accuracy und Generalisierungsfähigkeit der Modelle geführt haben also mit der Zielsetzung vereinbar sind und diese verbessern.
Da der Datensatz sehr dünn ist, haben einige Überlegungen keine ausreichende Unterstützung in den Daten. Um trotzdem die Logik hinter Modellen, ihren Dynamiken und passende Methodiken zu erkunden, werden trotzdem Annahmen aufgestellt, unter der Prämisse, dass diese bei dünnen Daten nicht unbedingt belastbar sind, es aber bei einem dichteren Datensatz eventuell wären.
Zuerst habe ich die Entwicklungsumgebung aufgesetzt. Die Anforderung für die Abgabe ist ein Python File, ich verwende VS Code als IDE, pyenv zur Verwaltung von Python Versionen und pipenv für eine virtuelle Umgebung um die Pythonversion von der anderer Projekte zu trennen. Versionierung wie üblich mit git.
Die Datei mit den Daten hat 164 Datensätze mit 1312 Datenpunkten, 7 Merkmale und ein kategoriales Zielmerkmal mit 3 Klassen. Ein erster Cleanup der Daten zeigt 62 Datensätze die mehrfach vorkommen (496 Datenpunkt) diese wurden entfernt. NaNs sind nicht vorhanden. In der Verteilung f/m erhalten wir nach Cleanup folgende Verteilung der Datensätze:
- 50 Datensätze Frauen
- 52 Datensätze Männer
Innerhalb der Daten gibt es starke Unterschiede zwischen den jeweiligen Geschlechtern, wenn man die Durchschnitte auswertet.
- Kinderanteil: 519 % höher bei den Frauen
- Gehälter: 46,4 % höher bei den Männern
- Credit Score: nur bei den Frauen gibt es den Score Low
Die niedrigeren Gehälter erklären sich teilweise dadurch, dass die Frauen im Datensatz statistisch jünger einen Kredit beantragen und zu diesen Zeiten weniger Gehälter aufweisen. Das ist relevant, weil selbst bei einer Entfernung von Geschlecht als Merkmal diese hohen Unterschiede als Proxy Value in den anderen Merkmalen erhalten bleiben können.
Eine Differenzierung: Es gibt in den Datensätzen einen historischen Bias aus den genannten Merkmalen aus der Datenauswahl/Erhebung. Dieser besteht in Durchschnittswerten und führt nur dann zu einem Bias im Modell wenn dieses eine Relation zwischen Geschlecht und den Werten herstellt. Es gilt also in den Auswertungen auf Diskrepanzen zwischen den Geschlechtern zu überprüfen. Würden z.B. Männer heraufgestuft und Frauen herabgestuft wäre das ein klares Zeichen für einen Bias.
Zur Aufbereitung des Modells habe ich kategoriale Merkmale in Zahlenwerte umgewandelt. Dabei Unterscheide ich zwischen nominalen Merkmalen und ordinalen Merkmalen. Erstere haben keine klare Reihenfolge und sollten per one-hot encoded werden. Jeder Klasse erhält dabei den Wert 0 oder 1. Da allerdings alle Merkmale dieser Art binär sind, z.B. m/w Wohnbesitz oder kein Wohnbesitz würde ein Encoding hier die Merkmale doppelt abbilden weil sie gekoppelt sind und damit stärker gewichten, daher codieren wir sie z.B. über 0 Männlich, 1 weiblich.
Am Ende ergibt sich:
- Age / Nr.
- Gender / categorial binary
- Income / Nr.
- Education / kategorial
- Marital Status / categorial binary
- Number of Children / ordinal
- Home Ownership / kategorial binary
- Credit Score / ordinal
Bei der Zahl der Kinder ist falls eine Relevanz vorliegt, diese mit wachsender Kinderanzahl zu erwarten weil dies mit finanziellen Aspekten verbunden ist und sich auch z.B. durch Teilzeit im Gehalt niederschlagen kann, daher sehe ich ordinal als sinnvoll an.
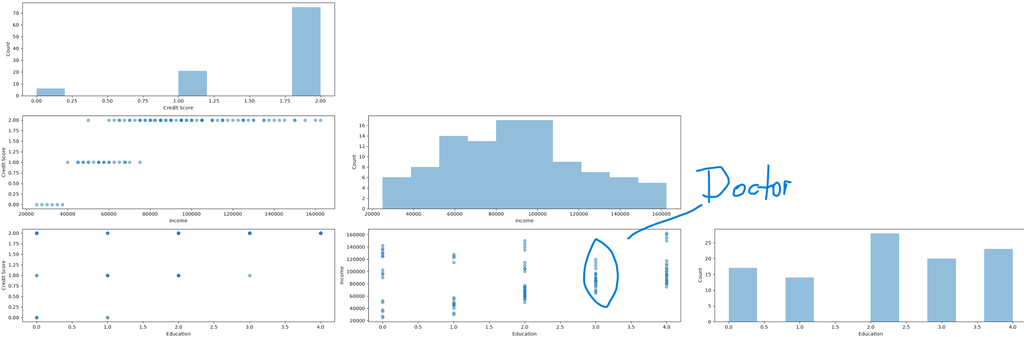
Bei der Education zeigt sich im Diagramm eine Korrelation zum Gehalt was auch für ordinal spricht allerdings sinkt das Gehalt beim Doktorgrad im Vergleich zum Master etwas, was kontraintuitiv ist, daher wird der Master hier höher eingeordnet.
Der K-nearest Algorithmus:
K-Nearest ist ein Lazy-Model. Es wird eigentlich kein Modell trainiert sondern auf Grundlage der Lage in Relation zu den Punkten des Trainings-Datensatz kategorisiert. Für jeden Punkt wird die Nähe zu mehreren anderen Datenpunkten herangezogen (den Sonderfall eines Datenpunktes lassen wir außen vor) und daraus die Kategorie berechnet.
Vor dem fitting habe ich den Datensatz in einen Trainings und Testdatensatz gesplittet. Zuerst habe ich dabei auf die Zieldaten stratifiziert um eine gleichmäßige Verteilung zu garantieren. Gerade mit wenigen Samples bei der Klasse „Low“ ist das extrem wichtig.
Eine erste Auswertung des Modells ergab folgende Accuracys:
- Accuracy Training: 0.9541984732824428
- Accuracy Test: 0.9090909090909091
Das klingt erst einmal gut. Allerdings wurde noch kein Scaler angewendet und auch nicht weiter optimiert. Methodisch gesehen sollte die Generalisationsfähigkeit nicht sehr hoch sein.
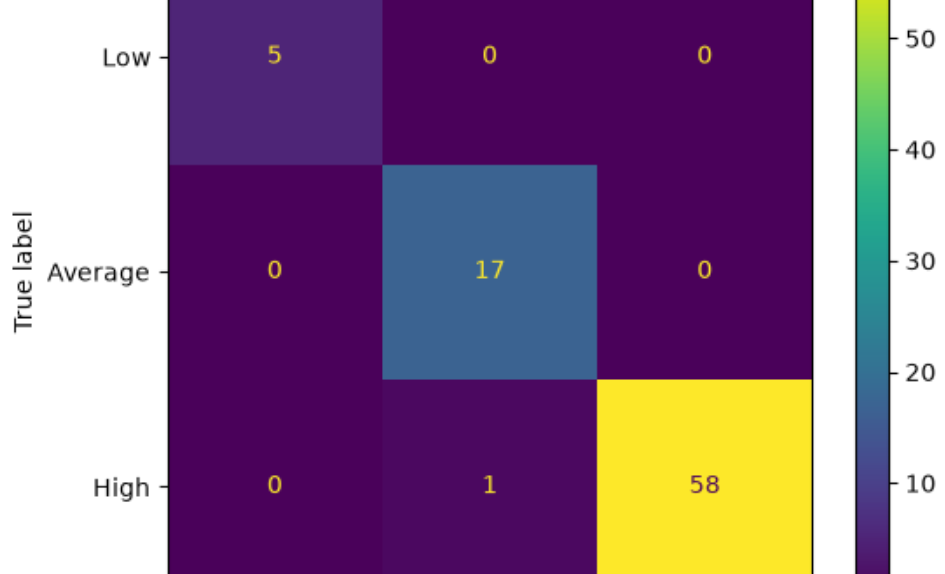
Ein Blick auf die Confusion Matrix zeigt hier:
Die Aufgabenstellung dieses Projektes ist das Training von Modellen zur Vorraussage der Kreditwürdigkeit (Credit Score). Es steht ein Datensatz zur Verfügung der mit 2 verschiedenen Machine Learning Modellen (K-nearest Neighbor, Decision Tree) trainiert werden soll und zusätzlich mit einem einfachen Neuronalen Netz mit einem versteckten Layer.
Ziel ist es bei jedem Klassifikationsalgorythmus eine möglichst hohe Accuracy zu erreichen. Diese Dokumentation soll dabei die Vorgehensweise festhalten und wie Änderungen bei dem Modell sich jeweils auf die Accuracy ausgewirkt haben.
Das Modell soll aso später die gelieferten Daten in Kategorien einteilen, die den Score darstellen. Neben Einkommen, Alter oder Wohnbesitz ist in dem Datensatz auch das Geschlecht angegeben. Das hat das Potential zu einem Gender Bias zu führen, welcher Personengruppen diskriminiert, darauf will ich zusätzlich differenziert eingehen.
An dieser Stelle sei vorweggenommen, dass die Betrachtung eines Gender-Bias und die entsprechenden Maßnahmen im Verlauf des Projektes zu einer Verbesserung der Accuracy und Generalisierungsfähigkeit der Modelle geführt haben also mit der Zielsetzung vereinbar sind und diese verbessern.
Zuerst habe ich die Entwicklungsumgebung aufgesetzt. Die Anforderung für die Abgabe ist ein Python File, daher wird das Modell kompakt und lokal gehalten, ich verwende VS Code als IDE, Pyenv zur Verwaltung von Python Versionen und Pipenv für eine virtuelle Umgebung um die Pythonversion von der anderer Projekte zu trennen.
Bestandsaufnahme
Die Datei mit den Daten hat 164 Datensätze mit 1312 Datenpunkten, 7 Merkmale und ein kategoriales Zielmerkmal mit 3 Klassen. Ein erster Cleanup der Daten zeigt 62 Datensätze die mehrfach vorkommen (496 Datenpunkt) diese wurden entfernt. NaNs sind nicht vorhanden.
In der Verteilung f/m erhalten wir nach Cleanup folgende Verteilung der Datensätze:
- 50 Datensätze Frauen (vorher 86)
- 52 Datensätze Männer (vorher 78)
Innerhalb der Daten gibt es starke Unterschiede zwischen den jeweiligen Gechlechtern wenn man die Durchschnitte auswertet.
- Kinderanteil: 519 % höher bei den Frauen
- Gehälter: 46,4 % höher bei den Männern
- Credit Score: nur bei den Frauen gibt es den Score Low
Die niedrigeren Gehälter könnten sich teilweise dadurch erklären, dass die Frauen im Datensatz in jüngerem Alter beginnen einen Kredit zu beantragen und zu diesen Zeiten weniger Gehälter aufweisen. Diese Unterschiede sind relevant, weil selbst bei einer Entfernung von Geschlecht als Merkmal diese hohen Unterschiede als Proxy Value in den anderen Merkmalen erhalten bleiben können.
Eine Differenzierung: Es gibt in den Datensätzen potentiell einen historisch/strukturellen Bias aus den genannten Merkmalen aus dem Datensatz. Dieser besteht in Durchschnittswerten und führt nur dann zu einem Bias im Modell wenn dieses eine Relation zwischen Geschlecht und den Werten herstellt. Es gibt also in den Auswertungen auf Diskrepanzen zwischen den Geschlechtern zu überprüfen. Würden z.B. Männer heraufgestuft und Frauen herabgestuft wäre das ein klares Zeichen für einen Bias. Das Ziel ist es einen zusätzlichen, den vorhandenen verstärkenden Bias zu verhindern.
Zur Aufbereitung des Modells habe ich kategoriale Merkmale in Zahlenwerte umgewandelt. Dabei unterscheide ich zwischen nominalen Merkmalen und ordinalen Merkmalen. Erstere haben keine klare Reihenfolge und sollten per one-hot encoded werden. Jeder Klasse erhält dabei den Wert 0 oder 1. Da allerdings alle Merkmale dieser Art binär sind, z.B. m/w Wohnbesitz oder kein Wohnbesitz würde ein Encoding hier die Merkmale doppelt abbilden weil sie gekoppelt sind und damit stärker gewichten, daher codieren wir sie z.B. über 0 Männlich, 1 weiblich.
Am Ende ergibt sich:
- Age / Nr.
- Gender / categorial binary
- Income / Nr.
- Education / kategorial
- Marital Status / categorial binary
- Number of Children / ordinal
- Home Ownership / kategorial binary
- Credit Score / ordinal
Bei der Zahl der Kinder ist falls eine Relevanz vorliegt, diese mit wachsender Kinderanzahl zu erwarten weil dies mit finanziellen Aspekten verbunden ist und sich auch z.B. durch Teilzeit im Gehalt niederschlagen kann, daher sehe ich ordinal als sinnvoll an. Bei der Education zeigt sich im Diagramm eine Korrelation zum Gehalt, was auch für ordinal spricht. Allerdings sinkt das Gehalt beim Doktorgrad im Vergleich zum Master etwas, was kontraintuitiv ist, daher wird der Master hier bewusst höher eingeordnet.
Der K-nearest Algorithmus:
K-Nearest ist ein Lazy Model. Es wird eigentlich kein Modell trainiert sondern auf Grundlage der Lage in Relation zu den Punkten des Trainings-Datensatz kategorisiert. Für jeden Punkt wird die Nähe zu mehreren anderen Datenpunkten herangezogen (den Sonderfall eines Datenpunktes lassen wir außen vor) und daraus die Kategorie berechnet. Vor dem fitting habe ich den Datensatz in einen Trainings und Testdatensatz gesplittet. Zuerst habe ich dabei auf die Zieldaten stratifiziert um eine gleichmäßige Verteilung zu garantieren. Gerade mit wenigen Samples bei der Klasse „Low“ ist das extrem wichtig.
Wir starten einen ersten Lauf des Modells ohne Duplicate Removal und Scaler, mit Stratifizierung:
- Accuracy Training: 0.9541984732824428
- Accuracy Test: 0.9090909090909091
Das klingt erst einmal gut. Allerdings zeigt eine Auswertung der Confusion Matrix ein anderes Bild.
Confusion Matrix - Trainingsset:
[[12  0  0]
 [ 0 18  4]
 [ 0  2 95]]
Confusion Matrix - Testset:
[[ 3  0  0]
 [ 1 11  2]
 [ 0  0 16]]
Das Modell hat also eine starke Tendenz Kredite hochzustufen, was für den Anwendungszweck völlig inakzeptabel ist. Außerdem ist die Generalisationsfähigkeit fragwürdig, weil noch kein Scaling erfolgt ist. Das Modell bevorzugt zu diesem Standmassiv das Einkommen.
Um ein genaueres Bild zu bekommen, ist es sinnvoll die Verteilung von Merkmalen zu betrachten. Wir tun dies vorerst am Beispiel von Alter und Einkommen. Eine Plot der Trennlinien ist bei multidimensionalen Merkmalen und so dünner Datenlage nicht gut möglich weil keine Grundlage für Extrapolation in den Schnitt vorliegt. Wir stellen statt dessen im Graf dar, ob Merkmale hoch oder runtergestuft werden.
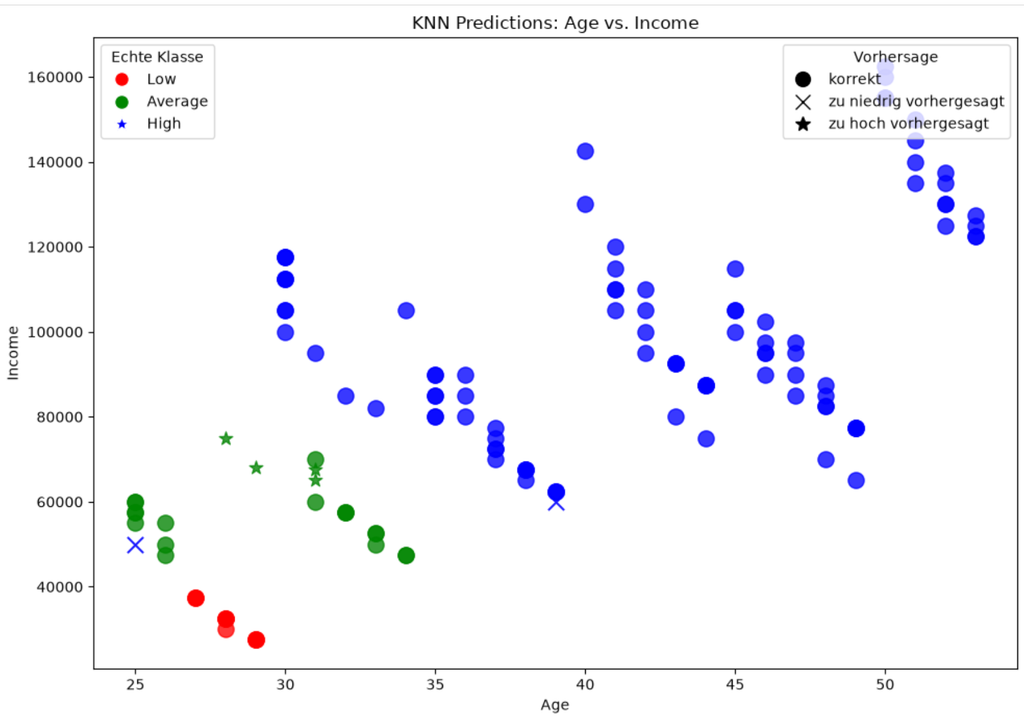
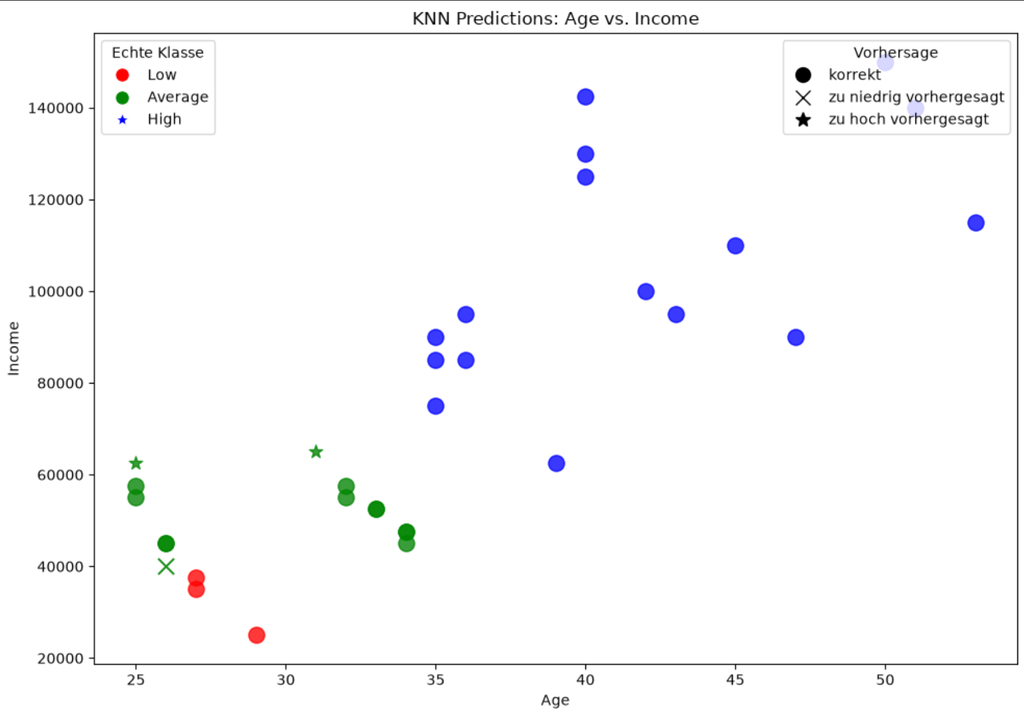
Das Bild zeigt eine Gruppierung von Hochstufungen und vereinzelte Herabstufungen. Zur Differenzierung: einzeln liegende Abweichungen lassen sich eher als Outlier oder Noise interpretieren. Sie werden im Modell bei hohen Neighbor Zahlen eher ausgeglättet. Räumlich nah strukturierte Fehler deuten auf ein Problem an der Einstufungsgrenze hin. Das kann an Überlappung liegen aber auch auf einen Bias hindeuten. Wir gehen hier von einem Bias aus und richten die weitere Strategie hierauf aus.
In den folgenden Schritten werden die Graphen nur interpretiert und nicht mehr im Einzelnen abgebildet weil das den Rahmen der Präsentation sprengen würde. Betrachten wir nach Gender Bias zeigt sich eine ähnliche Abweichung bei Männern und Frauen in der Accuracy:
Accuracy nach Gender und Credit Score:
   Gender    Class  Train Accuracy  Test Accuracy  Train Count  Test Count
0    Male      Low             NaN            NaN            0           0
1    Male  Average        0.769231       0.875000           13           8
2    Male     High        1.000000       1.000000           49           8
3  Female      Low        1.000000       1.000000           12           3
4  Female  Average        0.888889       0.666667            9           6
5  Female     High        0.958333       1.000000           48           8
Dieser Eindruck täuscht allerdings, wie die Confusion Matrix nach Geschlecht zeigt. Hier liegt ein starker Gender Bias vor(Training+Test):
Hochstufungen Herabstufungen
- Frauen 1 2
- Männer 4 1
Das Modell stuft also Frauen tendentiell herab und Männer hoch. Es scheint den historischen Bias der Daten zu augmentieren.
Duplicate Removal:
Mit Duplikaten werden einige Werte in k-nearest doppelt Erfasst und verzerren damit lokal die Grenzen der Klassen. Nach Duplicate Removal liegen die Wert wie folgt:
Accuracy Training: 0.9506172839506173
Accuracy Test:     0.8571428571428571
Die Werte haben sich auf dem Papier verschlechtert, aber methodisch sind wir auf bessere Generalisierbarkeit ausgerichtet. Ein Teil des vorherigen Ergebnisses ist durch die Dopplung gegeben, weil einige Daten in Training und Test übereinstimmen können.
Das Modell neigt jetzt zu Herabstufungen, benachteiligt aber laut confusion Matrix noch stärker die Frauen.
Hochstufungen Herabstufungen
- Frauen 0 6
- Männer 1 0
Bei weiteren Analyse die nicht einzeln aufgeführt werden zeigte sich dass Frauen in dem Model unter 28 Jahren nie eine hohe Einstufung bekamen, ungeachtet des Einkommens und weitere Benachteiligungen.
Implementierung des Scalers:
Wir haben bei den Merkmalen unterschiedliche Größenordnungen. Besonders bei den Gehältern sind die Distanzen mit bis zu 160.000 weitaus größer als z.B. Beim Alter. Damit wird die Distanzberechnung methodisch vom Einkommen dominiert. Mit dem hier gewählten MinMax-Scaler werden die Daten in den Bereich 0-1 gebracht. Wir wählen diesen statt dem Standard-Scaler, weil wir damit die binären Merkmale nachträglich besser auswerten können und sich kein Unterschied zum Standard-Scaler gezeigt hat.
Nach Anwendung des Scalers:
Accuracy Training: 0.9259259259259259
Accuracy Test:     0.9047619047619048
wir erreichen eine Verbesserung im Testset und eine Verschlechterung in der Accuracy. Diesmal verändert sich das Bild zugunsten der Frauen:
Hochstufungen/Herabstufungen
- Frauen 2 1
- Männer 0 3
Im Graph zeigt sich das wie folgt, wieder als starker Bias. Für die Männer nicht so betont, weil die hohe Klasse häufiger vorkommt.
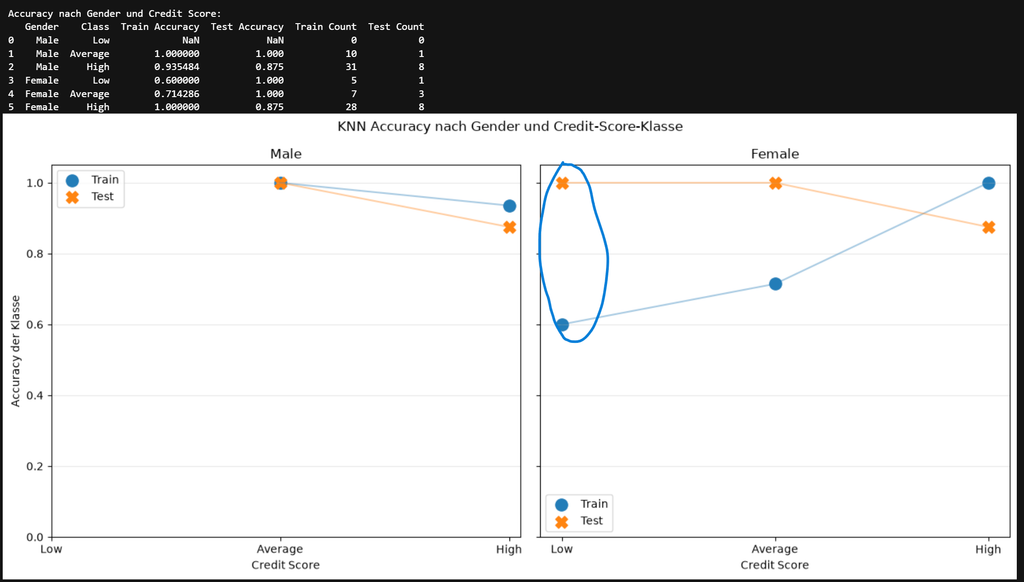
Im Kontext einer Risikobewertung ist das kritisch, weil die 2 Hochstufungen der Frauen auf nur 6 Low-Datensätze fällt. Gerade das Kritisch hohe Ausfallsrisiko wird also mit hohem Prozentsatz fehlinterpretiert.
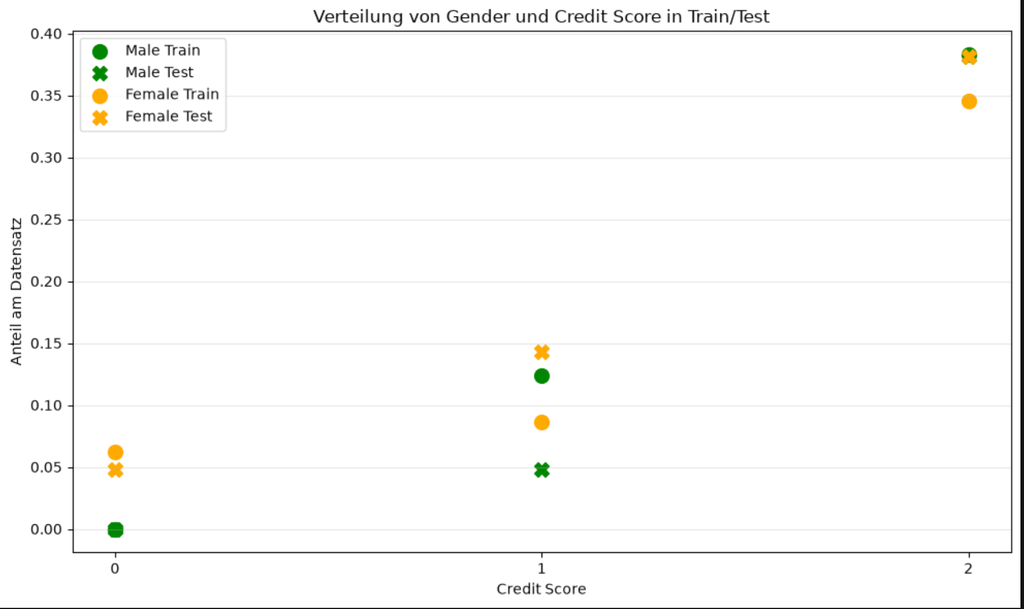
Sehen wir uns die Verteilung zwischen Testset und Trainingsset an, ergibt sich ein Ungleichgewicht, dass wir ausgleichen, indem wir zusätzlich zu den Zielklassen auf das Geschlecht stratifizieren. Das ist unsere Kernmaßnahme bezüglich des Gender Bias. Dies kann einen Bias nicht verhindern aber zusätzlichen Verzerrungen durch zufällige Splits entgegenwirken.
An dieser Stelle muss erwähnt werden dass natürlich die wiederholte Bertrachtung der Accuracy unter dem Gesichtspunkt nicht neutral ist und hier durch entsprechende Auswahl von Methoden das Modell entsprechend beeinflusst wird, was im Rahmen eines Studienprojektes mit kleinem generischen Datensatz, bei dem es um Demonstration von Entscheidungen und Methodik geht, anders gewertet werden kann, als in der Praxis.
Nach Stratifizierung:
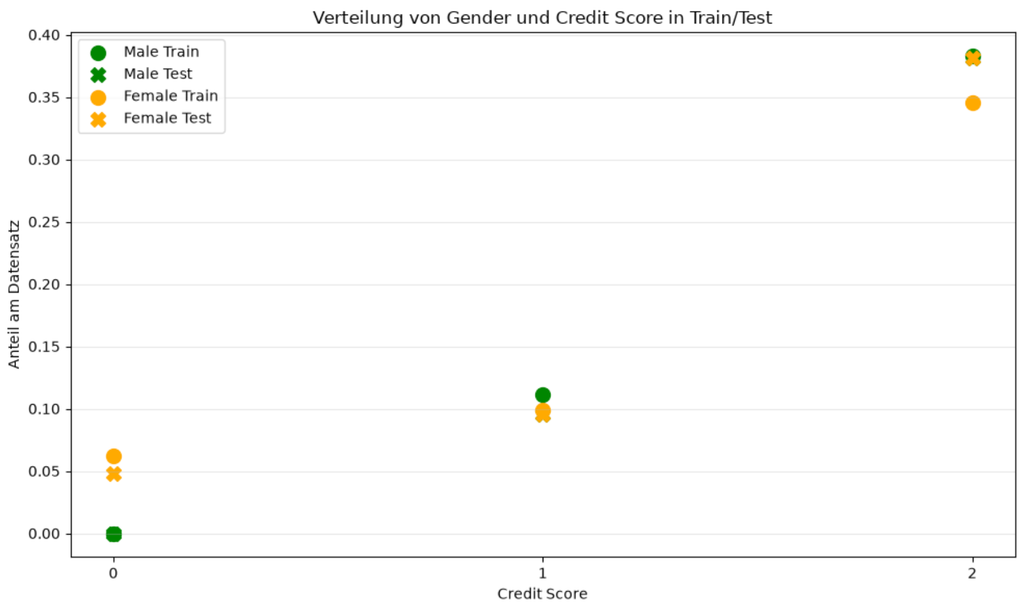
Die Werte haben sich dadurch allerdings wieder verschlechtert.
Accuracy Training: 0.9382716049382716
Accuracy Test:     0.8571428571428571
Im Plot Income/Age zeigt sich wieder eine starke Gruppierung und tendentiell mehr Bias. An dieser Stelle habe ich beschlossen ein GridSearch Verfahren einzusetzen, und zwar mit CrossValidierung.
GridSearch mit Cross Validierung
Wir variieren n_neighbors und p. Im Verlauf der Tests habe ich zusätzlich das mächtige Werkzeug der PCA zur Dimensionsreduktion hinzugenommen um den Fluch der Dimensionalität zu bekämpfen.
Nach einigen Experimenten zeigte sich, dass das Ergebniss über die Accuracy schlecht bewertet werden kann, weil teils utopisch gute Werte auftreten, die eine Überanpassung erwarten lassen. Die Accuracy des Trainings vergleicht außerdem Punkte mit sich selbst was einen eigenen Bias verursacht. Abhilfe schafft hier k-fold cross validation. Hier werden Punkte aus der Trainingsmenge ausgenommen.
Ich bilde die einzelnen K-Folds ab und achte neben dem Durchschnitt auf Abweichungen bei einzelnen Folds. Die Zahl ist auf 5 begrenzt, aufgrund der dünnen Datenlage bei der Zielklasse „Low“.
Bei weiterer Recherche ergibt sich das Bild, dass die Accuracy nicht aussagekräftig genug ist. Die Verteilung der Klassen ist stark heterogen (5,17,58). Da die Accuracy das Gesamtbild abbildet könnte es sein, dass z.B. 3 mal die Klasse Low fehlerkannt also hochgestuft wird und die Accuracy trotzdem hoch bleibt. Für die Verwendbarkeit eines Credit Score Modells wäre das katastrophal.
Ich wähle daher als Auswahlkriterium für GridSearch bewusst den macro F1 Score aus, der über die Klassen ausbalanciert betrachtet. Damit ist sichergestellt dass wir diese Möglichkeit ausschöpfen und wir vergleichen aus dieser Basis heraus die Accuracys. Zum finalen Vergleich lasse ich das Modell ohne und mit Gender-Stratifizierung gegeneinander antreten. Hier sind bei weitem nicht alle Auswertungen abgebildet. Ich habe mir natürlich auch Details wie Precision, Recall, F1 etc. ausgewertet.
Ohne Stratifizierung nach Gender:
Classification Report - Trainingsset:
              precision    recall  f1-score   support
           0       1.00      1.00      1.00         5
           1       0.88      0.88      0.88        17
           2       0.97      0.97      0.97        59
    accuracy                           0.95        81
   macro avg       0.95      0.95      0.95        81
weighted avg       0.95      0.95      0.95        81

Confusion Matrix - Trainingsset:
[[ 5  0  0]
 [ 0 15  2]
 [ 0  2 57]]
============================================================
GESAMTES TESTSET
============================================================

Classification Report - Testset:
              precision    recall  f1-score   support
           0       1.00      1.00      1.00         1
           1       1.00      1.00      1.00         4
           2       1.00      1.00      1.00        16
    accuracy                           1.00        21
   macro avg       1.00      1.00      1.00        21
weighted avg       1.00      1.00      1.00        21

Confusion Matrix - Testset:
[[ 1  0  0]
 [ 0  4  0]
 [ 0  0 16]]
============================================================
STABILITÄT ÜBER DIE EINZELNEN FOLDS
============================================================
 Fold  Train Macro F1  CV Macro F1  CV Accuracy  CV Balanced Accuracy
    1          0.9204       1.0000       1.0000                1.0000
    2          0.9411       0.9200       0.9375                0.8889
    3          0.9524       0.8864       0.8750                0.9444
    4          0.8910       0.9200       0.9375                0.8889
    5          0.9348       0.9471       0.9375                0.9697

CV Macro F1 - Mittelwert: 0.9347
CV Macro F1 - Standardabweichung: 0.0379
Mit gender Strat:
Classification Report - Trainingsset:
              precision    recall  f1-score   support

           0       0.83      1.00      0.91         5
           1       0.88      0.88      0.88        17
           2       0.98      0.97      0.97        59

    accuracy                           0.95        81
   macro avg       0.90      0.95      0.92        81
weighted avg       0.95      0.95      0.95        81


Confusion Matrix - Trainingsset:
[[ 5  0  0]
 [ 1 15  1]
 [ 0  2 57]]
============================================================
GESAMTES TESTSET
============================================================

Classification Report - Testset:
              precision    recall  f1-score   support

           0       1.00      1.00      1.00         1
           1       0.75      0.75      0.75         4
           2       0.94      0.94      0.94        16

    accuracy                           0.90        21
   macro avg       0.90      0.90      0.90        21
weighted avg       0.90      0.90      0.90        21


Confusion Matrix - Testset:
[[ 1  0  0]
 [ 0  3  1]
 [ 0  1 15]]
============================================================
STABILITÄT ÜBER DIE EINZELNEN FOLDS
============================================================
 Fold  Train Macro F1  CV Macro F1  CV Accuracy  CV Balanced Accuracy
    1          0.8748       0.9390       0.9412                0.9744
    2          0.9548       1.0000       1.0000                1.0000
    3          0.9548       1.0000       1.0000                1.0000
    4          0.9012       1.0000       1.0000                1.0000
    5          0.8898       0.8864       0.8750                0.8864

CV Macro F1 - Mittelwert: 0.9651
CV Macro F1 - Standardabweichung: 0.0459
Interpretation:
Wie wir sehen können, scored das Modell ohne gesonderte Stratifizierung beim Testset perfekt. Das kann ein Hinweis auf ein zufällig optimal ausgewähltes Testset sein. Bei der dünnen Datenlage wäre eine Aussage hierzu nicht gut belastbar. Wir nehmen hier also die CV Auswertung hinzu.
Hier ergibt sich ein klareres Bild.
Betrachten wir hier die CV Macro F1 Werte und die Accuracy über mehrere Folds, ist das gender-stratifizierte Modell auf höherem Niveau, mit dem selben Minimum von 0.875 wie das einfach stratifizierte Modell. Die Standartabweichung ist zwar minimal höher aber das liegt eher am insgesamt höheren Mittelpunkt. Das weist bei genauer Begutachtung auf eine bessere Generalisierbarkeit hin. CV Macro F1 – Mittelwert: 0.9651 vs. CV Macro F1 – Mittelwert: 0.9347. Daher wählen ich den stratifizierten Weg als den finalen Ansatz, weil dieser auch methodisch besser aufgebaut ist.
Unsere Confusion Matrix zeigt nun: Hochstufungen Herabstufungen
- Frauen 2 1
- Männer 0 2
Das ist immer noch kein ausgeglichenes Bild, diesmal mit Benachteiligung der Männer. Es kann aber darauf hinweisen, dass das Modell weil es geschlechterspezifische Merkmale tendentiell ignoriert, eventuell einen historischen Bias etwas ausgleicht. Insgesamt ist es ausgeglichener als der Startpunkt. Abermals besteht eine zu dünne Datenlage für eine klare Aussage.
Schlussfolgerung zu k-nearest Modell:
Wir haben das Modell optimiert indem wir alle üblichen Methodiken wie Duplikatentfernung, Stratifizierung, Scaler und GridSearch angewendet haben. Es hat sich gezeigt, dass es hilfreich ist verschiedenen Metriken hinzuzuziehen um das Modell zu bewerten und ein klareres Bild zu erhalten. Insbesondere die Metriken zu k-folds waren hier ausschlaggebend.
Eine differenzierte Betrachtung des Gender Bias war nicht nur für das Modell hilfreich. Ein solcher Bias ist ein gesamtgesellschaftliches Problem bei dem sich durch den Boom von Machine Learning und KI vorhandende Diskriminierungen potenzieren können. Damit lastet die Verantwortung von Gegenmaßnahmen oder zumindest einem Bewusstsein für die Problematiken auf Denen, die die Datensätze zusammenstellen, trainieren oder anwenden.
Decision Tree
Beim Decision Tree folge ich einem ähnlichen Ansatz wie bei k-nearest. Die Daten sind bereits weitestgehend aufbereitet. Ein Scaler kommt hier nicht zum Einsatz, weil er bei dem Verfahren nicht notwendig ist.
Decion Trees teilen die Daten über Regeln in einer baumartigen Entscheidungsstruktur auf. z.B. Gehalt < 100.000 etc. Um eine Entscheidung zu fällen versuchen sie die Präzision zu Messen die sich durch die Entscheidung ergibt. Wieviel klarer abgetrennt werden die beiden Abzweigungen der Entscheidung durch die gesetzte Regel. Dazu können sie Gini verwenden oder die auf Shannon basierte Entropy. Gini wurde erstmals in den 70er Jahren zur Erfassung von Einkommensungleichheit in Kanada verwendet. Die Shannon Entropy stammt aus der Informationstheorie (1948) und war ursprünglich gedacht, um die minimale Menge an Zeichen zu ermitteln, welche notwendig sind um ein Information zu codieren. Um das Netzwerk zu optimieren kann man die Tiefe, die Anzahl der Daten pro Leaf (Ende einer Verzweigung) oder die Mindestanzahl verbleibender Daten an der Verzweigung festlegen.
Wir beginnen mit einem unbegrenzten Baum, der bereits die volle Stratifizierung aufweist und zusätzlich k-folds um hier direkt eine Bewertung zu haben. In der Darstellung (s.o.) zeigt sich keine Entscheidungsgrenze über das Geschlecht. Was auffällt ist, dass der Hausbesitz stark gewichtet wird. Wir können uns hier die Feature-Importance anzeigen lassen und erhalten diese Reihenfolge:
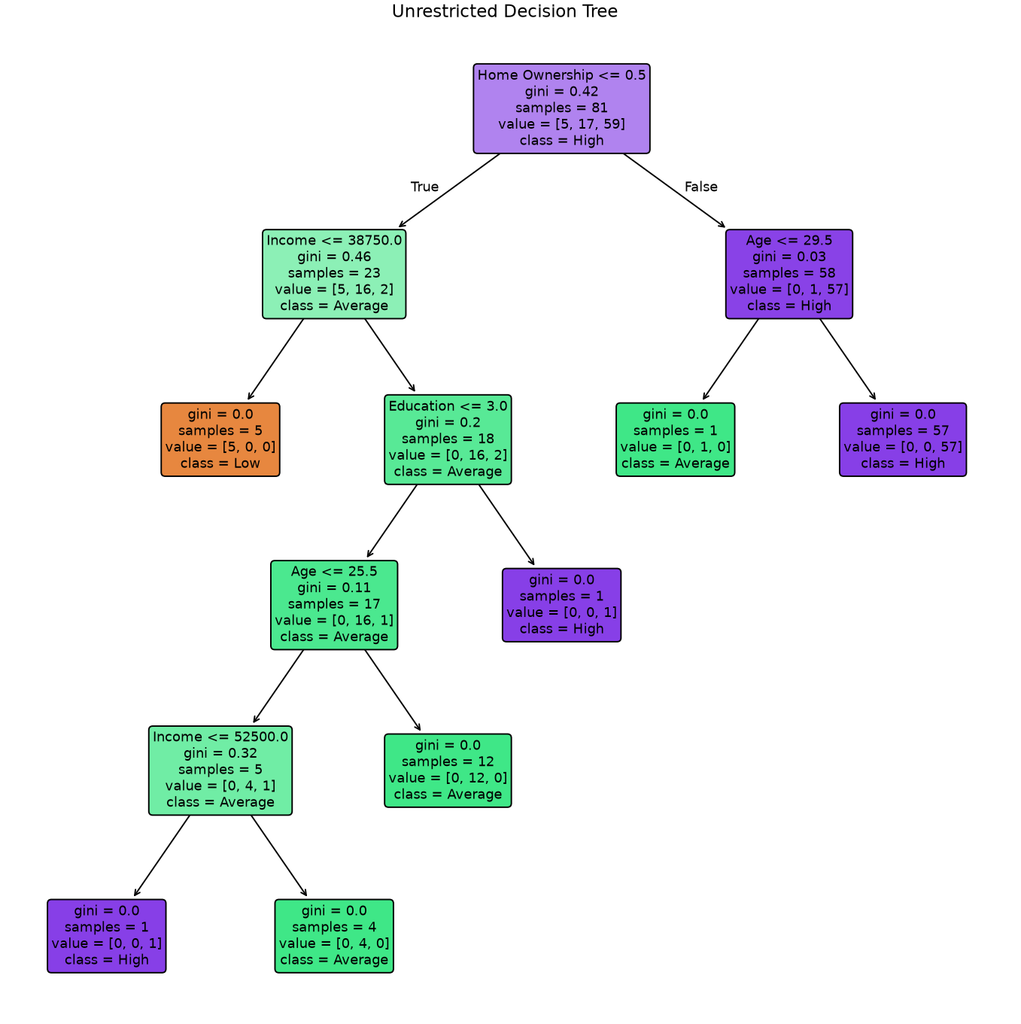
Referenzwerte für den Decision-Region-Plot:
Age                      39.0
Gender                    1.0
Income                85000.0
Education                 2.0
Marital Status            1.0
Number of Children        0.0
Home Ownership            1.0
An dieser Stelle zeigt sich eine geringe Bedeutung des Alters und der Bildung. Geschlecht, Kinder und Ehestand haben keinen Einfluss.
Accuracy Training: 0.9506
Accuracy Testset: 0.9048
============================================================
KOMPLEXITÄT DES DECISION TREES
============================================================
Baumtiefe: 5
Anzahl Blätter: 7
Anzahl Knoten: 13
Die Komplexität hält sich für ein unbegrenztes Modell noch im Rahmen. Trotzdem kann hier eine Überanpassung vorliegen. Cross Validation zeigt ein symetrischeres Startbild als k-nearest aber mit Herabstufung der Männer.:
Hochstufungen Herabstufungen
- Frauen 1 1
- Männer 1 2
GridSearch
Nach diesem guten Startergebniss implementiere ich wieder GridSearchCV. Dabei variiere ich die Entropy und Class-Weight-Variation, wodurch die Klassen anders gewichtet werden.
Als beste Parameterkombination erhalte ich hier:
============================================================
BESTE PARAMETERKOMBINATION - DECISION TREE
============================================================
criterion: gini
max_depth: 2
min_samples_split: 2
min_samples_leaf: 1
class_weight: None
Bester CV Macro-F1: 0.9651
Als Accuracy:
Accuracy Training: 0.9753086419753086
Accuracy Test:     0.9047619047619048
Auch hier sind meine Folds wieder relativ stabil:
============================================================
STABILITÄT ÜBER DIE EINZELNEN FOLDS
============================================================
 Fold  Train Macro F1  CV Macro F1  CV Accuracy  CV Balanced Accuracy
    1          0.9848       0.9390       0.9412                0.9744
    2          0.9705       1.0000       1.0000                1.0000
    3          0.9705       1.0000       1.0000                1.0000
    4          0.9691       1.0000       1.0000                1.0000
    5          0.9841       0.8864       0.8750                0.8864

CV Macro F1 - Mittelwert: 0.9651
CV Macro F1 - Standardabweichung: 0.0459
Als Vergleich dazu die Werte ohne Gender Stratifizierung:
Accuracy Training: 0.9876543209876543
Accuracy Test:     1.0
============================================================
STABILITÄT ÜBER DIE EINZELNEN FOLDS
============================================================
 Fold  Train Macro F1  CV Macro F1  CV Accuracy  CV Balanced Accuracy
    1          0.9841       0.5700       0.8824                0.5833
    2          0.9849       1.0000       1.0000                1.0000
    3          1.0000       0.7633       0.8750                0.8611
    4          0.9849       0.9200       0.9375                0.8889
    5          0.9674       0.9471       0.9375                0.9697
Die Accuracy ist hier höher, aber die Folds geben eine Hinweis auf schlechtere Generalisierbarkeit und auch der Wert der Accuracy ist eher utopisch. Interessant ist dass in diesem Modell nur Alter und Einkommen gewertet werden, während das Andere Modell Home Ownership, Einkommen und Alter berücksichtigt, also völlig andere Maßgaben. Es scheint mir logisch, dass 3 Werte die auch Rücklagen und Absicherung beinhalten aussagekräftiger sind. Da die Werte zusätzlich über die CV-Folds hier besser sind, entscheide mich also wieder für das voll stratifizierte Modell.
Hier zeigt sich beinahe das selbe Bild wie bei k-nearest. Es gibt einzelne Abweichungen, bei den Männern in 2 Fällen mehr nach unten, sonst eher symetrisch. Es gibt aber keine Hochstufungen im Hochrisikobereich.
Hochstufungen Herabstufungen
- Frauen 1 1
- Männer 0 3
Schlussfolgerung zum Decision Tree:
Basierend auf der Vorarbeit zu k-nearest war der Decision Tree schnell zu implementieren. Hier haben wir den klaren Vorteil, dass wir die Entscheidungen des Modells durch die Sichtbarkeit der Grenzen und die Relevanz der Merkmale besser beurteilen können. Das erlaubt ein besseres Abschätzen der Funktionsweise des Modells. Bei einem so dünnen Datensatz sind die Interpretationen aber teils Kaffeesatzlesen. Ich habe mich auf Methodik fokussiert und Generalisierbarkeit sowie Biasvermeidung statt auf kleine durch einzelne Punkte verursachte Verschiebungen.
Das Endergebniss ist besser als der Ausgangswert bei einem vereinfachten Baum der eine bessere Generalisierungsfähigkeit erwarten lässt. Auch hier hat die zusätzliche Stratifizierung geholfen.
Neuronales Netz:
Ich erstelle ein Klasse für ein Neuronales Netz die sich von den Befehlen und Parameternamen in den bisherigen Workflow integrieren lässt. Es gibt eine Eingabeschicht aus 7 Neuronen mit Eingabefunktion, einen Hidden Layer mit vorerst ebenfalls 7 Neuronen, ihre Anzahl wird später variiert. Für die Ausgabeschicht gehe ich gleich noch auf die Neuronenanzahl ein. Zusätzlich gibt es Geister-Neuronen für den Bias mit einer konstanten Ausgabe von 1. zwischen Schichten 1,2 und 2,3 werden Gewichte etabliert. Das Netzwerk hat die übliche Forward und eine Backwards Propagation. Bei der Wahl der Neuronen der Ausgabeschicht wird es komplizierter.
Betrachten wir die Ausgabe weiter als ordinales Merkmal, so erhalten erhalten wir eine kontinuierliche Ausgabe auf Basis einer Regression. Diese würden dann von 0 bis >2 rangieren und auf die 3 Werte 0,1,2 geclampt, repräsentativ für Low, Medium, High. Damit das funktioniert ist aber vorausgesetzt, dass die Abstände zwischen den korrelierenden Eingangswerten einigermaßen gleichmäßig liegen,
Die 2te Option ist, nominal zu denken und per one-hot encoding 3 Klassen auf 3 Neuronen zu erzeugen die sich gegenseitig ausschließen. Hier wäre dann Softmax die Aktivierungsfunktion der Wahl und CCE statt MSE die Loss Funktion.
Die 3te Option ist am interessantesten: Ordinal Classification mit 2 Outputs:
- > Low
- > Medium
Dadurch gibt es 2 Merkmale die sich nicht vollständig ausschließen und das Netzwerk kann einen ordinalen Bezug lernen ohne dass es gleichmäßige Abstände geben muss. Ich entscheide mich daher für diesen Ansatz.
Nach Aufbau des NN und Übergabe der Daten zeigt sich eine klare Abwärtstendenz des Losses über mehrere Epochen, wobei das Trainingset etwas über dem Testset liegt und diesen nach etwa 8000 epochen wieder übersteigt. Nach einige Bugfixes zeigt sich ein 100 % korrektes Testset bei allerdings sehr hoher Neuronenzahl als POC. Ich reduziere die Neuronen auf 5 als Anfangswert und erhalte auch hier eine korrekte Voraussage im Testset. Um die Ergebnisse wirklich bewerten zu können, integriere ich eine Funktion zum Berechnen der Accuracy und eine Confusion Matrix.
Beim Training des Modells mit 5 Neuronen, 5000 Epochen und eta 0.01 zeigen sich folgende Werte:
Accuracy
---------------------------
Training Accuracy: 0.9877
Test Accuracy:     1.0000
Die Confusion Matrix für das Testset können wir uns somit sparen. Für das Training sieht sie wie folgt aus:
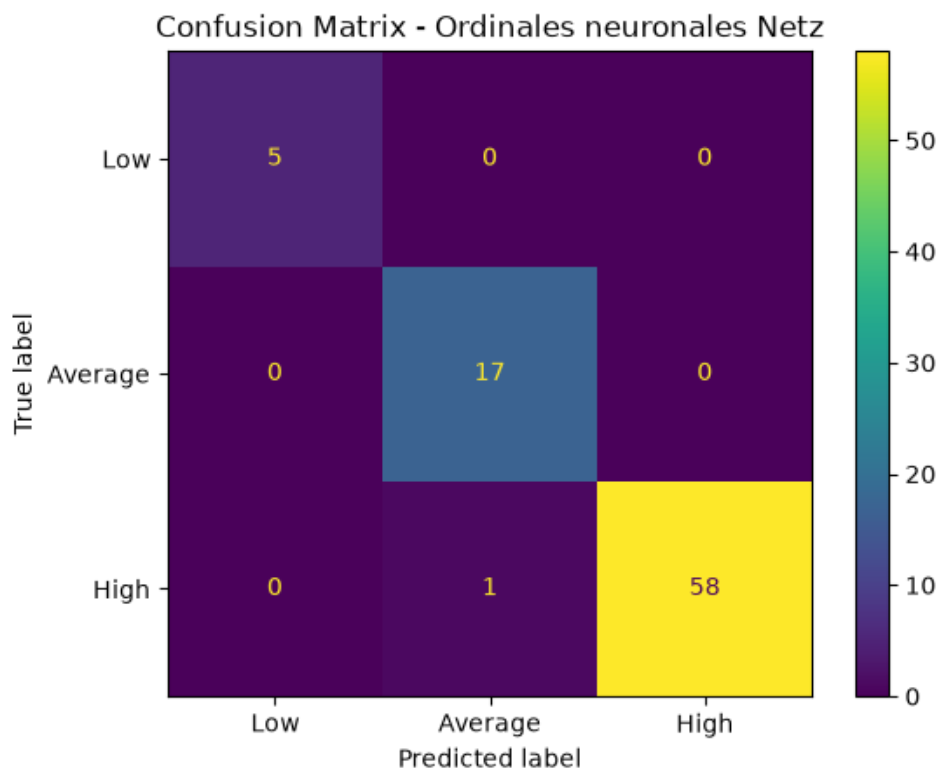
Unser Netzwerk hat also ad hoc ein hervorragendes Ergebniss geliefert. Dies liegt mit Sicherheit auch an der Vorbereitung der Daten und der erweiterten Stratifizierung sowie dem besonderen Ansatz bei der Ausgabeschicht.
Das es bei dem Projekt um Explorieren und Praxiserfahung geht, führen ich weitere Tests durch.
Ich überprüfe zunächst, ob sich die Ausgabe bei weniger oder mehr Neuronen ändert. Ich beginne mit 2 Neuronen und finde hier zu dem selben Ergebnis. Ich erhöhe Testweise auf 10 was in der Praxis eine Überanpassung provozieren kann um zu sehen ob die einzelne Fehlklassifizierung im Trainingsset verschwindet, was nicht der Fall ist. Ich setze den Wert wieder auf 5 und erhöhe die Zahl der Epochen. Damit erhalte ich eine perfekte Matrix für das Training aber eine Abweichung im Testset.
Nach diesen Tests setze ich mich mit dem passenden Stoppunkt für das Training auseinander. Die Loss-Kurven sollen dabei helfen. Der ideale Punkt für einen Stop ist wenn die Validierung durch das Testset stagniert, bevor sie aufgrund einer Überanpassung an das Testset beginnt, wieder zu steigen. Auch wenn es möglich ist dies direkt in den Code einzubetten, löse ich es für den Lerneffekt manuell.
Ich gebe eine Kurve mit vielen Epochen aus, wähle einen Abbruchpunkt und begrenze das Training auf diesen.
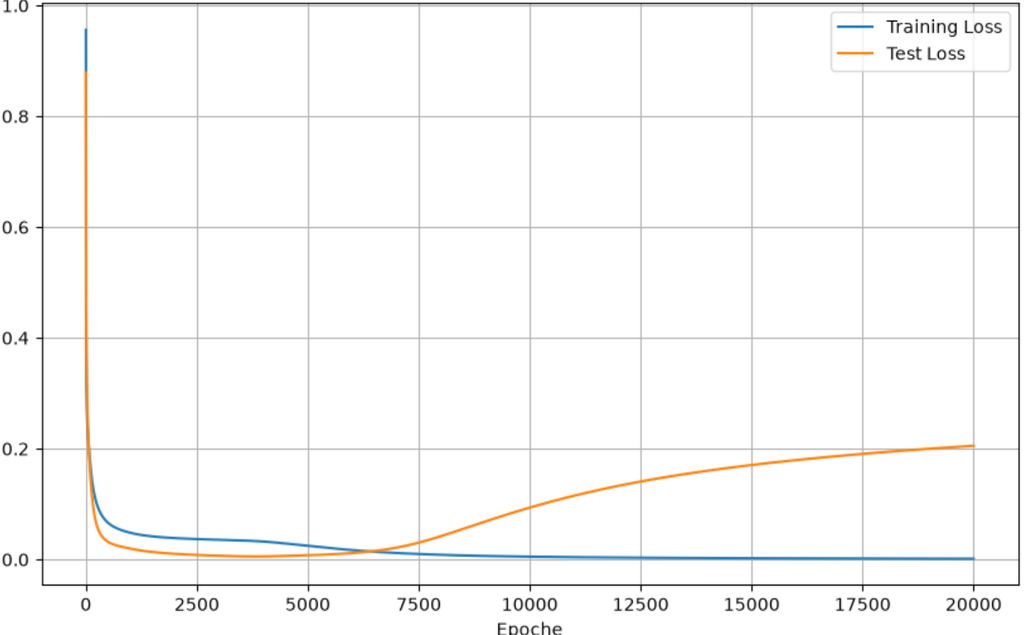
Der obige Graph zeigt klar den Anstieg des Losses beim Testset. Ich wähle meinen Wert bei 3500 weil etwa dort die Kurve stagniert. Hier zeigt sich das selbe Ergebniss wie vorher. Um die Auswertung zu erweitern füge ich einen Classification Report hinzu.
============================================================
GESAMTES TRAININGSSET
============================================================
Classification Report - Trainingsset:
              precision    recall  f1-score   support
         Low       1.00      1.00      1.00         5
     Average       0.94      1.00      0.97        17
        High       1.00      0.98      0.99        59
    accuracy                           0.99        81
   macro avg       0.98      0.99      0.99        81
weighted avg       0.99      0.99      0.99        81

============================================================
GESAMTES TESTSET
============================================================
Classification Report - Testset:
              precision    recall  f1-score   support
         Low       1.00      1.00      1.00         1
     Average       1.00      1.00      1.00         4
        High       1.00      1.00      1.00        16
    accuracy                           1.00        21
   macro avg       1.00      1.00      1.00        21
weighted avg       1.00      1.00      1.00        21
Ein k-fold ist in meiner Lösung in der verbleibenden Projektzeit nicht zu implementieren. Meine Prognose ist, dass das Modell gut trainiert und generalisierungsfähig ist. Die hohen Werte spiegeln das wieder und der Early Stop sollte methodisch dazu beitragen. Um trotzdem noch zu experimentieren teste ich mit Neuronenzahlen von 3-7 und tausche anschließend testweise die Aktivierungsfunktion aus.
| Neuronenzahl | Fehlklassifizierung Testset / Trainingsset | 0,000 | Accuracy Test | Geschätzter Early Stop |
| 3 | 0/1 | 0,963 | 1 | 250 |
| 4 | 0/1 | 0,984 | 1 | 700 |
| 5 | 0/1 | 0,987 | 1 | 1200 |
| 6 | 0/1 | 0,987 | 1 | 2000 |
| 7 | 0/1 | 0,987 | 1 | 3000 |
Wie sich ablesen lässt liegt das Optimum bei 5 Neuronen also der Zahl mit der ich gestartet bin. Danach gibt es keinen Zugewinn mehr solange man Overfitting vermeiden will.
Als nächstes Ersetzen wir die Sigmoid-Funktion durch Relu und testen erneut. Hier zeigt sich dass die Validierungskurve sehr früh abweicht. Bereits bei 120 im Vergleich zu vorher. In der Kurve zeigt sich ein gewisses Zittern was auf Probleme im Gradient Descent hinweisen könnte, deshalb setze ich eta auf 0.005 und teste erneut. Die Kurve ist tatsächlich glatter, was für das Ergebniss irrelevant ist.
Training Accuracy: 0.9877
Test Accuracy:     0.9524
Relu hat einen schlechteren Score beim Testset, ist aber beim Trainingsset identisch. Es bietet sich mit 10mal weniger Epochen bis zum Eearly Stop als guter Tradeoff zwischen Genauigkeit und Geschwindigkeit an, wenn es um große Datensätze geht. Da wir hier kleine Datensätze vorliegen haben, bleiben wir bei Sigmoid. Der Unterschied lässt sich vermutlich darauf zurückführen dass Sigmoid im Gegensatz zu Relu nicht linear ist. Weil es nur eine Fehlklassifizierung gibt, betrachten wir in diesem Fall nicht mehr die Confusion Matrix für Männer und Frauen.
Schlussfolgerung:
Der Ansatz beim Neuronalen Netz hat extrem schnell zu einem sehr brauchbaren Ergebnis geführt und keines der weiteren Experimente konnte dieses weiter verbessern. Die Accuracy liegt über der der beiden Anderen Methoden und ist so sind die Trainingsmöglichkeiten, wie das Modell sich verhält wahrscheinlich voll ausgereizt. Alles darüber wäre eine Überanpassung.
FAZIT
Im Projekt hat sich gezeigt, dass die reine Accuracy alleine kein ausreichendes Kriterium zur Bewertung eines Modells ist. Gerade bei einem kleinen und ungleich verteilten Datensatz waren Cross Validation, Macro-F1, Confusion Matrices und die Betrachtung einzelner Gruppen wesentlich hilfreicher um die tatsächliche Qualität und Generalisierungsfähigkeit einzuschätzen. Besonders deutlich wurde das bei der zusätzlichen Stratifizierung nach Credit Score und Gender, die sowohl bei K-Nearest als auch beim Decision Tree zu besseren bzw. stabileren Ergebnissen geführt hat.
Gleichzeitig wurde deutlich, wie unterschiedlich die drei Verfahren auf die Daten reagieren und entsprechend unterschiedlich vorbereitet und optimiert werden müssen. Beim K-Nearest waren Scaling, PCA und die Distanzmetrik besonders relevant, während beim Decision Tree eher Baumtiefe und die Begrenzung der Entscheidungsstruktur eine Rolle spielten. Beim selbst implementierten neuronalen Netz kamen zusätzlich Lernrate, Anzahl der Hidden-Neuronen, Aktivierungsfunktion und die Wahl eines geeigneten Abbruchpunkts über die Loss-Kurve hinzu.
Ein weiteres wichtiges Learning war für mich, dass eine hohe Modellgüte nicht automatisch bedeutet, dass ein Modell auch sinnvoll oder fair arbeitet. Die Untersuchung möglicher Gender-Verzerrungen hat gezeigt, dass bereits die Zusammensetzung und Aufteilung des Datensatzes einen erheblichen Einfluss auf die Ergebnisse haben kann. Insgesamt war deshalb nicht die Maximierung eines einzelnen Scores das wichtigste Ergebnis des Projektes, sondern das Verständnis dafür, wie Datenaufbereitung, Modellwahl, Hyperparameter, Bewertungsmetriken und mögliche Biases zusammenspielen und gemeinsam über die Aussagekraft eines Machine-Learning-Modells entscheiden.
Bezüglich der Aussagekraft und Anwendbarkeit würde ich in der Praxis in diesem Anwendungsfall den Decision Trees den Vorrang geben, auch wenn die neuronalen Netze in allen Werten klar vorne liegen. Der Grund liegt in der Transparenz und der im Beispiel dünnen Datenlage. Bei k-nearest kommt es bei dünnen Daten zwangsläufig zu nichtlinearen organischeren Grenzen und Verzerrungen was klare Kriterien bei Kreditvergabe angeht.
Im Decision Tree verlaufen diese bei geringer Tiefe klarer und sind nachvollziehbarer was im Finanzsektor wichtig sein kann auch um Regeln abzuleiten oder zu analysieren. Das kann es eventuell auch vereinfachen das Risiko gegen die Entscheidungskriterien gegenzurechnen und so Kreditraten und andere Faktoren zu berechnen. Neuronale Netze sind im Vergleich intransparenter. Hier ist in solchen Fällen nicht immer klar wie gut sie generalisieren.